BytPCSobremesa
2026BytPC
PC a medida BytPC · Estación IA (9950X + RTX 5090)
32 GB de VRAM y 96 GB de RAM: entrena LoRA, genera vídeo y ejecuta LLM de 70B cuantizados.
Rendimiento86
4599 €
Qué hardware hace funcionar qué modelos (texto, imagen, vídeo, voz), a qué velocidad y cuánto cuesta. Con los modelos abiertos del catálogo de Bytgon y una calculadora para tu caso.
Un modelo de lenguaje necesita en memoria de GPU aproximadamente parámetros × bytes por parámetro × 1,2. A 4 bits (lo habitual en local) un modelo de 8B ocupa ~5 GB, uno de 27B ~18 GB y uno de 70B ~46 GB. La velocidad depende del ancho de banda: una RTX 5090 (1.792 GB/s) genera ~20 tokens/s con un 70B a 4 bits; un Mac Studio M3 Ultra (819 GB/s) lo mueve a ~9 tok/s pero puede cargar modelos de 400B que no caben en ninguna gráfica de consumo.
Core Ultra / Ryzen AI / Snapdragon X con 16-32 GB: modelos de 1-8 B a Q4 (Phi-4 mini, Gemma 4 4B, Qwen 8B), Whisper, Kokoro. 10-30 tok/s.
900 € – 1800 €LLM de 7-9 B a Q4 (~40-60 tok/s), SDXL, FLUX NF4, LTX-Video 2B. Para empezar.
900 € – 1300 €LLM de 14-27 B a Q4 (~25-45 tok/s), FLUX.1 FP8, Wan 2.2 5B, HunyuanVideo con descarga. El punto dulce calidad-precio.
1300 € – 2200 €LLM de 32 B a Q4 o 70 B a Q3 (RTX 5090 ~20 tok/s), FLUX.2 FP8, Wan 2.2 14B FP8, entrenamiento de LoRA.
2800 € – 5500 €LLM de 70-120 B a Q4 (M4 Max 128 GB ~8-12 tok/s; M3 Ultra 512 GB corre DeepSeek V4 a Q4 ~6 tok/s). Generación de imagen más lenta que NVIDIA.
2400 € – 12.000 €Modelos de 120-400 B, inferencia para equipos, fine-tuning completo. Pide presupuesto a nuestro taller de montaje.
9000 € – 40.000 €| Familia | Tamaños | Fuerte en | Dónde corre |
|---|---|---|---|
| Qwen 3.5 / 3.6 / 3.8 Alibaba (Qwen) · Apache 2.0 | 0.6B, 1.7B, 4B, 8B, 9B, 14B, 27B, 32B MoE: Qwen3.5-35B-A3B (3B activos de 35B), Qwen3.5-122B-A10B (10B activos de 122B), Qwen3.5-397B-A17B (17B activos de 397B) | razonamiento, código, multilingüe (español excelente), visión en variantes omni | Ollama, LM Studio, llama.cpp, vLLM |
| DeepSeek V4 / R1 (y destilados) DeepSeek · MIT | 1.5B, 7B, 8B, 14B, 32B, 70B MoE: DeepSeek-V4 Flash (15B activos de 230B), DeepSeek-V4 Pro (37B activos de 671B) | razonamiento profundo y matemáticas; los destilados de 7-32B caben en una gráfica de 8-24 GB | Ollama, llama.cpp, vLLM, SGLang |
| Gemma 4 Google · Gemma (uso comercial permitido) | 1B, 4B, 12B, 27B, 31B MoE: Gemma 4 26B-A4B (4B activos de 26B) | muy eficiente por tamaño, visión, 140 idiomas; 27-31B corre en una RTX 5090 o Mac de 48 GB | Ollama, LM Studio, llama.cpp, MLX |
| Llama 3.3 / Llama 4 Meta · Llama Community | 1B, 3B, 8B, 70B MoE: Llama 4 Scout (17B activos de 109B), Llama 4 Maverick (17B activos de 400B) | ecosistema enorme, fine-tuning fácil; Llama 4 Scout con 10M de contexto | Ollama, llama.cpp, vLLM, MLX |
| Mistral Small / Medium / Devstral Mistral AI · Apache 2.0 (Small/Devstral) | 3B, 8B, 12B, 24B | europeo, excelente en español y francés, visión y código (Devstral) | Ollama, llama.cpp, vLLM |
| GPT-OSS OpenAI · Apache 2.0 | MoE: gpt-oss-20b (3.6B activos de 21B), gpt-oss-120b (5.1B activos de 117B) | razonamiento ajustable; el 20B corre en 16 GB y el 120B en una sola RTX PRO 6000 o Mac de 96 GB | Ollama, llama.cpp, vLLM, LM Studio |
| Phi-4 Microsoft · MIT | 3.8B, 14B | pequeño y muy capaz en matemáticas y razonamiento; ideal para portátiles con NPU | Ollama, ONNX Runtime, llama.cpp |
| Kimi K2 Moonshot AI · Modified MIT | MoE: Kimi K2 (32B activos de 1000B) | agentes y uso de herramientas; solo en servidores multi-GPU o Mac Studio 512 GB a Q4 | vLLM, SGLang, llama.cpp |
Pesos descargables para ejecutar en tu equipo. Si no tienes el hardware, los mismos modelos están disponibles en la nube en API Bytgon y en el estudio Bytgon AI.
550 modelos en api.bytgon.com (210 abiertos, 152 gratuitos). Para cada modelo abierto de texto calculamos la memoria a 4 bits y la gráfica mínima.
| Modelo | Parámetros | Memoria a 4 bits | Hardware mínimo | Contexto |
|---|---|---|---|---|
qwen3.8-2.4t-a95balibaba | 2.4T (95B activos) | ~1584 GB | solo servidores | 1049k |
nemotron-3-ultra-550b-a55bnvidia | 550B (55B activos) | ~363 GB | Mac Studio 512 GB o multi-GPU | 262k |
nemotron-3-ultra-550b-a55b:freenvidia · gratis en la nube | 550B (55B activos) | ~363 GB | Mac Studio 512 GB o multi-GPU | 1000k |
qwen3.5-397b-a17balibaba | 397B (17B activos) | ~263 GB | Mac Studio 512 GB o multi-GPU | 262k |
qwen3-vl-235b-a22b-thinkingalibaba | 235B (22B activos) | ~156 GB | Mac Studio 512 GB o multi-GPU | 131k |
qwen3-vl-235b-a22b-instructalibaba | 235B (22B activos) | ~156 GB | Mac Studio 512 GB o multi-GPU | 262k |
qwen3-235b-a22b-thinking-2507alibaba | 235B (22B activos) | ~156 GB | Mac Studio 512 GB o multi-GPU | 131k |
qwen3-235b-a22b-2507alibaba | 235B (22B activos) | ~156 GB | Mac Studio 512 GB o multi-GPU | 262k |
qwen3-235b-a22balibaba | 235B (22B activos) | ~156 GB | Mac Studio 512 GB o multi-GPU | 131k |
qwen3.5-122b-a10balibaba | 122B (10B activos) | ~81 GB | Mac Studio / Strix Halo 128 GB o RTX PRO 6000 | 262k |
nemotron-3-super-120b-a12bnvidia | 120B (12B activos) | ~80 GB | Mac Studio / Strix Halo 128 GB o RTX PRO 6000 | 262k |
nemotron-3-super-120b-a12b:freenvidia · gratis en la nube | 120B (12B activos) | ~80 GB | Mac Studio / Strix Halo 128 GB o RTX PRO 6000 | 262k |
gpt-oss-120bopenai | 120B | ~80 GB | Mac Studio / Strix Halo 128 GB o RTX PRO 6000 | 131k |
qwen3-next-80b-a3b-thinkingalibaba | 80B (3B activos) | ~53 GB | Mac Studio / Strix Halo 128 GB o RTX PRO 6000 | 262k |
qwen3-next-80b-a3b-instructalibaba | 80B (3B activos) | ~53 GB | Mac Studio / Strix Halo 128 GB o RTX PRO 6000 | 262k |
qwen2.5-vl-72b-instructalibaba | 72B | ~48 GB | Mac Studio / Strix Halo 128 GB o RTX PRO 6000 | 128k |
qwen-2.5-72b-instructalibaba | 72B | ~48 GB | Mac Studio / Strix Halo 128 GB o RTX PRO 6000 | 33k |
llama-3.3-70b-instructmeta | 70B | ~47 GB | Mac Studio / Strix Halo 128 GB o RTX PRO 6000 | 131k |
llama-3.1-70b-instructmeta | 70B | ~47 GB | Mac Studio / Strix Halo 128 GB o RTX PRO 6000 | 131k |
qwen3.6-35b-a3balibaba | 35B (3B activos) | ~24 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
qwen3.5-35b-a3balibaba | 35B (3B activos) | ~24 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
qwen3-vl-32b-instructalibaba | 32B | ~22 GB | RTX 4090 / 5090 o Mac 32 GB | 131k |
qwen3-32balibaba | 32B | ~22 GB | RTX 4090 / 5090 o Mac 32 GB | 131k |
qwen-2.5-coder-32b-instructalibaba | 32B | ~22 GB | RTX 4090 / 5090 o Mac 32 GB | 33k |
gemma-4-31b-it | 31B | ~21 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
gemma-4-31b-it:freegoogle · gratis en la nube | 31B | ~21 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
nemotron-3-nano-omni-30b-a3b-reasoning:freenvidia · gratis en la nube | 30B (3B activos) | ~20 GB | RTX 4090 / 5090 o Mac 32 GB | 256k |
nemotron-3-nano-30b-a3bnvidia | 30B (3B activos) | ~20 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
qwen3-vl-30b-a3b-thinkingalibaba | 30B (3B activos) | ~20 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
qwen3-vl-30b-a3b-instructalibaba | 30B (3B activos) | ~20 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
qwen3-30b-a3b-thinking-2507alibaba | 30B (3B activos) | ~20 GB | RTX 4090 / 5090 o Mac 32 GB | 82k |
qwen3-coder-30b-a3b-instructalibaba | 30B (3B activos) | ~20 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
qwen3-30b-a3b-instruct-2507alibaba | 30B (3B activos) | ~20 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
qwen3-30b-a3balibaba | 30B (3B activos) | ~20 GB | RTX 4090 / 5090 o Mac 32 GB | 131k |
qwen3.6-27balibaba | 27B | ~18 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
qwen3.8-27balibaba | 27B | ~18 GB | RTX 4090 / 5090 o Mac 32 GB | 1000k |
qwen3.5-27balibaba | 27B | ~18 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
gemma-3-27b-it | 27B | ~18 GB | RTX 4090 / 5090 o Mac 32 GB | 131k |
gemma-2-27b-it | 27B | ~18 GB | RTX 4090 / 5090 o Mac 32 GB | 8k |
gemma-4-26b-a4b-it | 26B (4B activos) | ~18 GB | RTX 4090 / 5090 o Mac 32 GB | 262k |
| Modelo | VRAM fp16 / fp8 / 4 bits | Velocidad | Licencia |
|---|---|---|---|
| FLUX.1 [dev] / [schnell] Black Forest Labs · 12B · ComfyUI, Forge, Diffusers, DrawThings (Mac) texto en imagen, manos, fotorrealismo | 24 / 12 / 8 GB | RTX 4090: ~10 s/imagen (dev, 20 pasos); RTX 5090: ~6 s; M4 Max: ~45 s | schnell Apache 2.0; dev no comercial |
| FLUX.2 [dev] Black Forest Labs · 32B · ComfyUI, Diffusers edición multirreferencia, coherencia de personajes | 64 / 32 / 18 GB | RTX 5090 FP8: ~15 s/imagen; necesita 32 GB o descarga por bloques | no comercial (dev) |
| Stable Diffusion XL Stability AI · 3.5B · ComfyUI, A1111/Forge, Fooocus, DrawThings miles de LoRA y checkpoints; corre en casi cualquier GPU de 8 GB | 8 / 6 / 4 GB | RTX 3060: ~8 s; RTX 5070: ~2,5 s; Mac M4: ~25 s | OpenRAIL++ |
| Stable Diffusion 3.5 Large Stability AI · 8B · ComfyUI, Diffusers tipografía y adherencia al prompt | 18 / 11 / 7 GB | RTX 4090: ~6 s | Community (gratis <1 M $ ingresos) |
| Qwen-Image Alibaba · 20B · ComfyUI, Diffusers texto en imagen (incluido chino/español), edición | 40 / 22 / 12 GB | RTX 5090 FP8: ~12 s | Apache 2.0 |
| HiDream-I1 HiDream · 17B · ComfyUI licencia MIT y calidad fotográfica | 34 / 20 / 12 GB | RTX 5090 FP8: ~14 s | MIT |
| Modelo | VRAM mín. / recomendada | Velocidad | Licencia |
|---|---|---|---|
| Wan 2.2 (5B TI2V / 14B A14B MoE) Alibaba · 14B · 720p (5B) · 720p-1080p (14B) · ComfyUI, Diffusers la mejor calidad abierta; texto→vídeo e imagen→vídeo | 8 / 24 GB | RTX 5090: 5 s de vídeo 720p en ~2-4 min (14B FP8); 5B en ~1 min; RTX 4070 12 GB: 5B con descarga | Apache 2.0 |
| HunyuanVideo 1.5 Tencent · 8.3B · 480p-1080p · ComfyUI, Diffusers movimiento natural, imagen→vídeo | 14 / 24 GB | RTX 4090: 5 s 720p en ~3-6 min | Tencent Community |
| LTX-2 / LTX-Video 13B Lightricks · 13B · hasta 4K (LTX-2) · 1216x704 (13B) · ComfyUI, Diffusers velocidad en tiempo casi real, audio sincronizado (LTX-2) | 8 / 16 GB | RTX 4090: 5 s en ~20-40 s (distilled); el más rápido | LTXV Open Weights |
| CogVideoX 1.5 5B Zhipu AI · 5B · 1360x768 · ComfyUI, Diffusers ligero y abierto | 8 / 16 GB | RTX 4090: 5 s en ~3 min | Apache 2.0 |
| Mochi 1 Genmo · 10B · 848x480 · ComfyUI movimiento fluido 30 fps | 16 / 24 GB | RTX 4090: 5 s en ~5 min | Apache 2.0 |
| Modelo | Tarea | VRAM | Velocidad |
|---|---|---|---|
| Whisper large-v3 / turbo OpenAI · MIT · whisper.cpp, faster-whisper, MLX | transcripción | 6 GB | RTX 4070: 1 h de audio en ~2 min (turbo); M4: ~6 min; CPU: 30-60 min |
| Kokoro 82M hexgrad · Apache 2.0 · kokoro, ONNX | texto a voz · español incluido | 1 GB | tiempo real ×50 en GPU; funciona en CPU |
| F5-TTS SWivid · CC-BY-NC (modelo) / MIT (código) · f5-tts, ComfyUI | clonación de voz | 4 GB | tiempo real ×5 en RTX 3060 |
| Chatterbox Resemble AI · MIT · chatterbox-tts | texto a voz con emoción | 4 GB | tiempo real ×8 en RTX 4070 |
| MusicGen / ACE-Step Meta / ACE Studio · CC-BY-NC / Apache 2.0 · ComfyUI, audiocraft | música | 8 GB | ACE-Step: 4 min de música en ~20 s en RTX 4090 |
32 GB de VRAM y 96 GB de RAM: entrena LoRA, genera vídeo y ejecuta LLM de 70B cuantizados.
Lo máximo sin montar nada: RTX 5090 de 32 GB para 4K 240 Hz e IA local seria.
Torre gaming de marca con RTX 5080 y refrigeración líquida; garantía y soporte Dell.
Torre premium con líquida de 360 mm y RTX 5080.
El portátil RTX 5090 más fino: 1,7 cm y 2,1 kg con OLED 240 Hz.
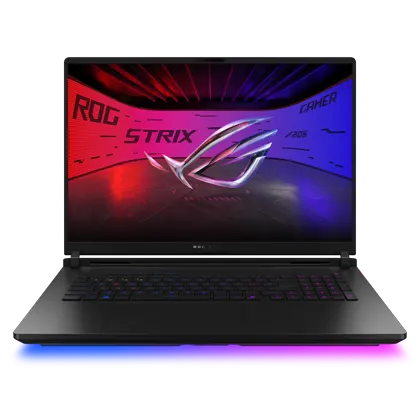
Sustituto de sobremesa con RTX 5090 y mini-LED 240 Hz.
El portátil más potente que existe: RTX 5090 de 24 GB, 64 GB de RAM y 4K mini-LED.
Lo montamos en nuestra red de tiendas con piezas estándar y garantía de 3 años.